2021 gehörten wir zu den ersten Unternehmen, die ein Enterprise-AI-Produkt entwickelt haben. Seitdem haben wir viel darüber gelernt, woran KI in der Industrie scheitert und was sie erfolgreich macht. Eine der wichtigsten Erkenntnisse: Metadaten sind entscheidend. Dieser Artikel wird an manchen Stellen etwas technisch, aber ich lade Sie ein, dranzubleiben. Denn ich bin überzeugt, dass dieses Thema für jedes Unternehmen relevant ist, das seine Dokumentation für KI nutzbar machen will. Und ich glaube, dass genau hier in den kommenden Jahren entschieden wird, welche Unternehmen mit KI erfolgreich sind und welche nicht.
Ein Servicetechniker kommt mit KNOWRON zu einem Serviceeinsatz beim Kunden und steht vor einer Maschine, die er womöglich noch nie gesehen hat. Er scannt den QR-Code am Gehäuse und erhält genau die Dokumentation, die er braucht, in der richtigen Sprache. Das wirkt einfach, weil es für den Techniker auch einfach ist.
Damit der Zugriff auf Informationen für den Techniker so einfach und korrekt funktioniert, muss vorher deutlich anspruchsvollere Arbeit geleistet werden. In diesem Artikel teile ich die wichtigsten Feinheiten rund um Metadaten in der industriellen Dokumentation und was wir bei KNOWRON in fünf Jahren Praxis darüber gelernt haben, wie man sie löst. Wenn das Thema für Ihr Unternehmen relevant ist und Sie tiefer einsteigen möchten, schreiben Sie uns gerne an ask@knowron.com.
Die Brownfield-Herausforderung
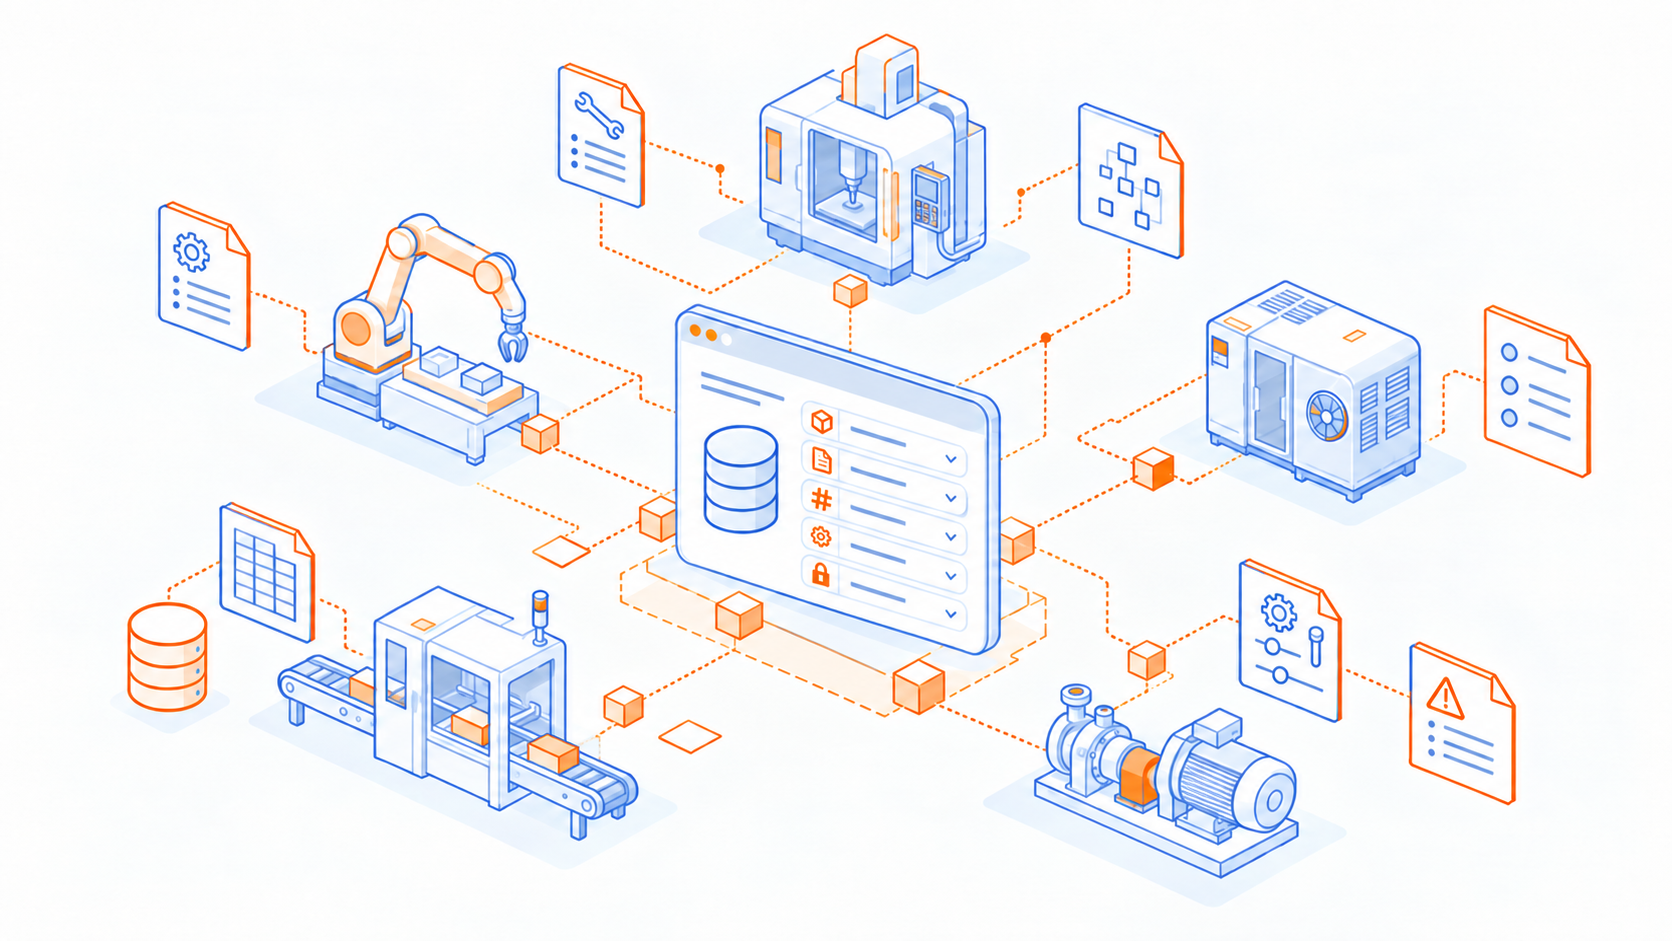
Bevor ein QR-Code etwas Brauchbares liefern kann, muss das System einige grundlegende Fragen beantworten können. Zum Beispiel: Welche Dokumente gehören zu welcher Maschine? Nicht nur die Betriebsanleitung, sondern der richtige Revisionsstand, Schaltpläne, Serviceinformationen, Ersatzteillisten und alles andere, was zu diesem Modell oder Seriennummernbereich gehört.
Dann geht es um Zugriffsrechte. Wer darf das Dokument sehen? Hat ein Servicepartner Zugriff? Ist es nur für den internen Gebrauch bestimmt? Ein Schaltplan und eine Bedienungsanleitung für Kunden können sich auf dieselbe Maschine beziehen. Das heißt aber nicht, dass sie denselben Personen zur Verfügung stehen sollten.
Und schließlich: Wo liegen all diese Informationen überhaupt? Meist lautet die Antwort: überall. Ein Teil liegt in SAP, ein Teil im Dokumentenmanagementsystem, ein Teil auf einem Fileserver.
Das Wissen ist vorhanden, nur nicht in nutzbarer Form
Hersteller wissen in der Regel, welche Dokumente zu welchen Maschinen gehören. Das Problem: Dieses Wissen ist selten konsistent und strukturiert erfasst. Ein erfahrener Ingenieur weiß vielleicht, dass eine Version der Anleitung bis zu einer bestimmten Seriennummer gilt und danach eine andere. Jemand im Service weiß, dass eine Serviceinformation aus dem letzten Jahr eine ältere Anweisung ersetzt hat. Eine Kollegin aus dem Compliance-Bereich weiß, welche Dokumente mit Kunden geteilt werden dürfen und welche im Unternehmen bleiben müssen.
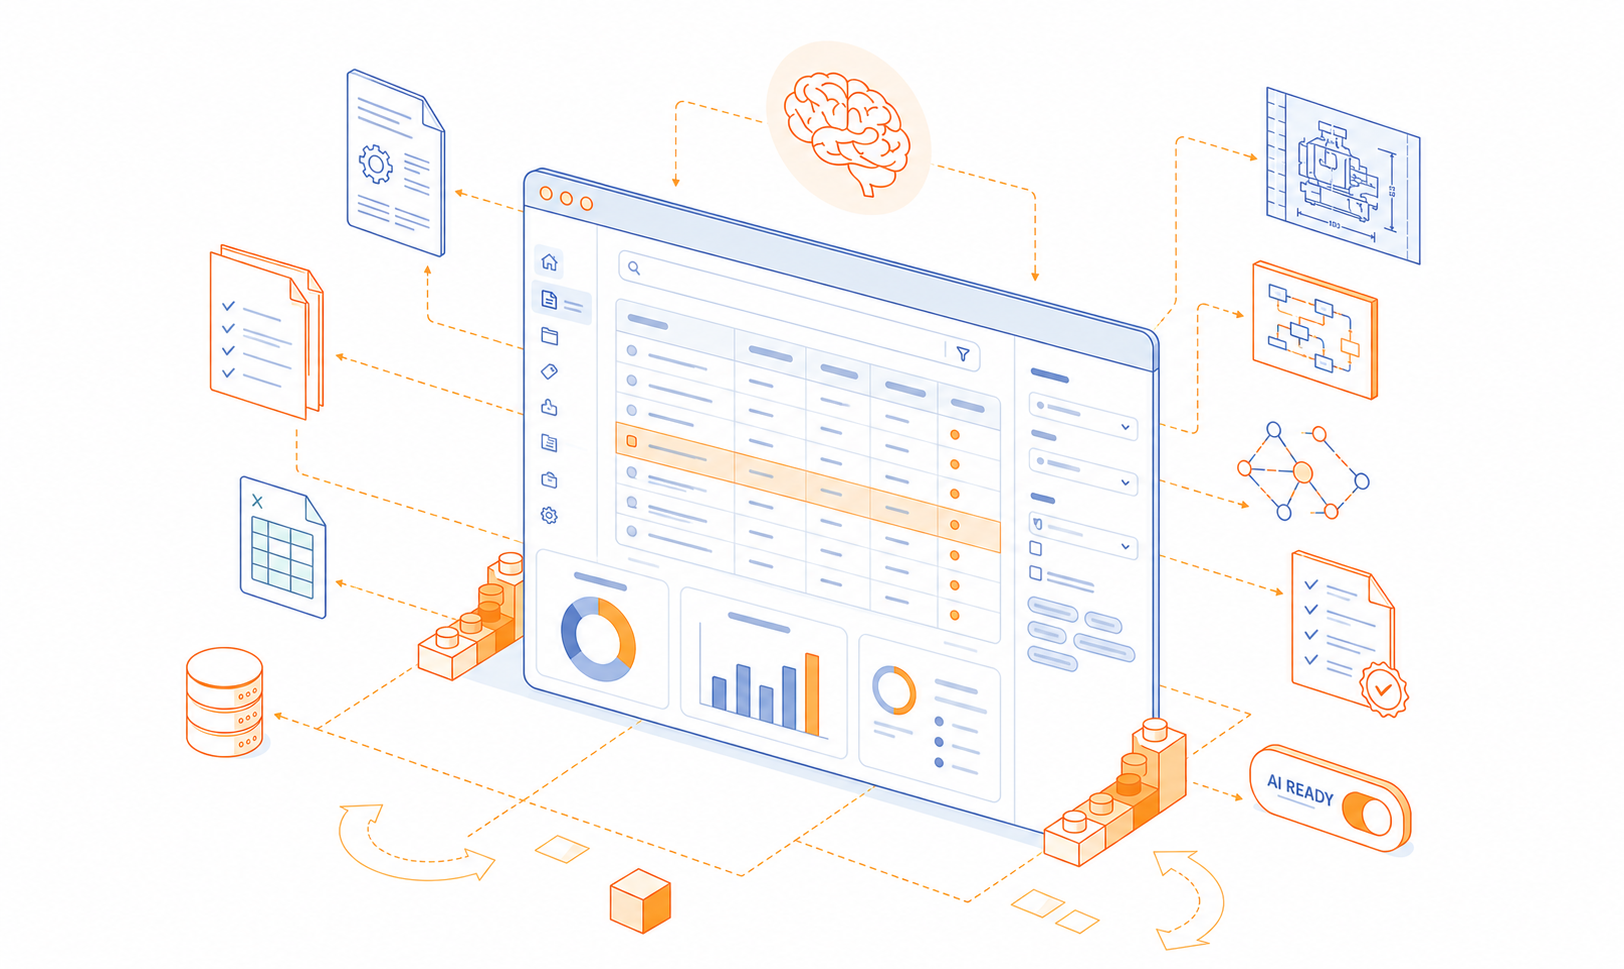
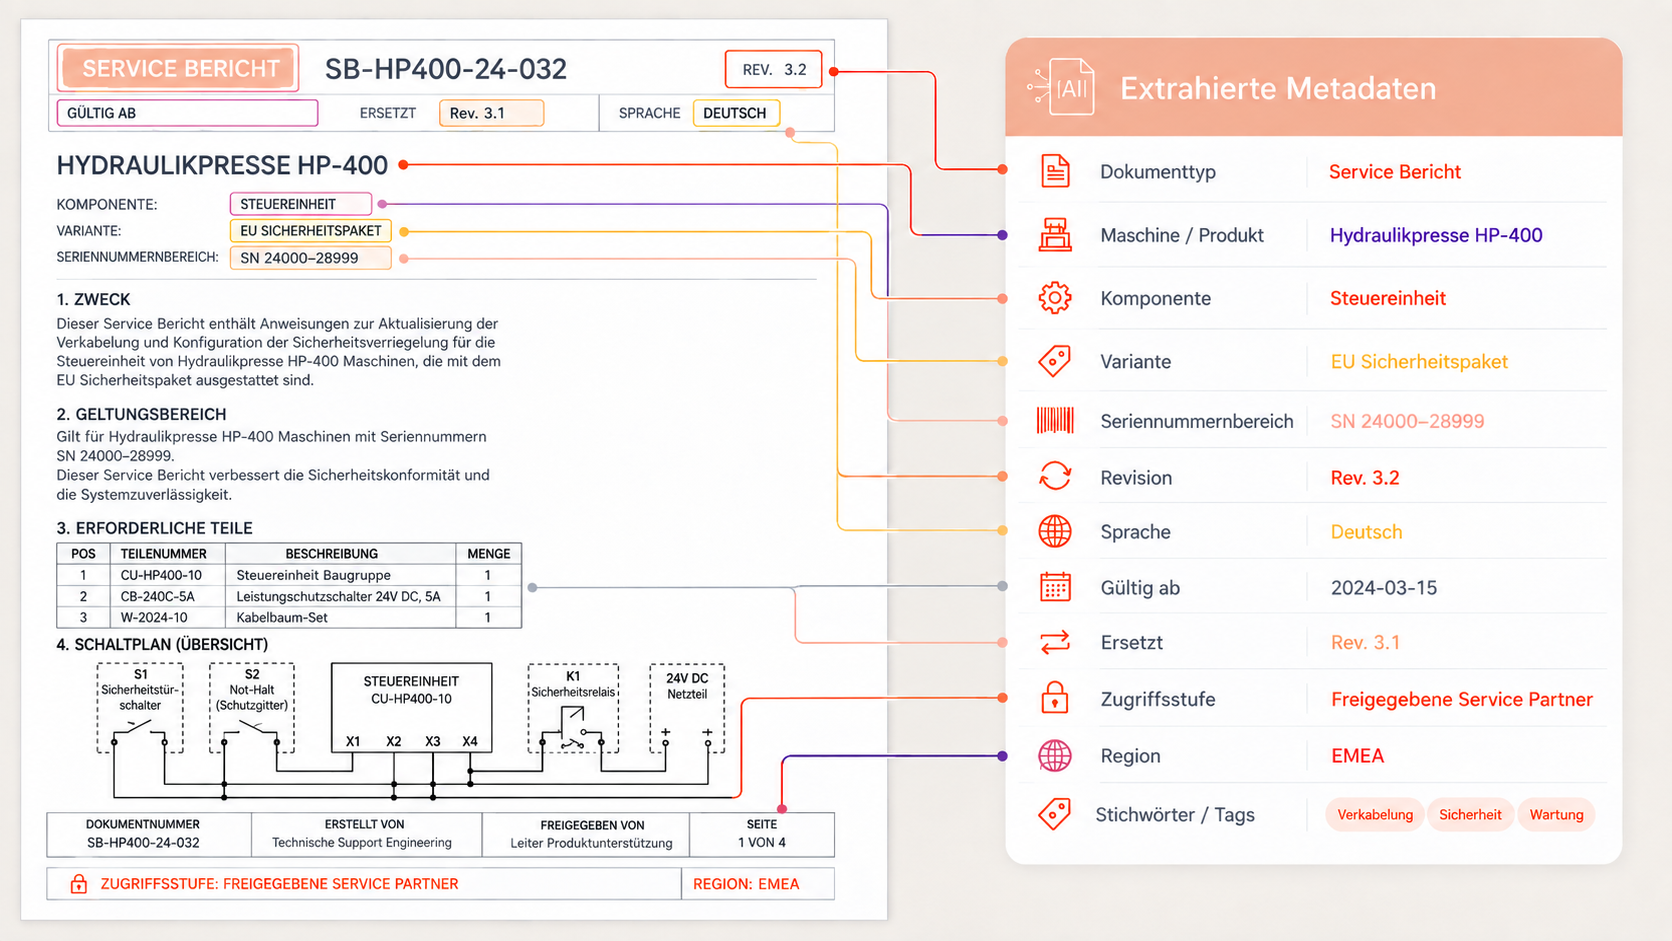
Solange dieses Wissen aber nur in Köpfen, Dateinamen, Ordnerstrukturen und isolierten Systemen existiert, kann Software wenig damit anfangen. Genau hier kommen Metadaten ins Spiel. Metadaten sagen einem System, um welche Art von Dokument es sich handelt, für welches Produkt oder welche Maschine es gilt, welche Version aktuell ist, was es ersetzt und wer es sehen darf. In vielen Unternehmen wurden diese Informationen nie sauber erfasst.
Damit KI in Ihrem Unternehmen gut funktioniert, müssen Sie dieses Wissen maschinenlesbar machen. Der große Zusatznutzen: Sie ermöglichen damit nicht nur den Einsatz von KI, sondern machen sich auch unabhängiger vom Weggang erfahrener Mitarbeitender. Wenn Spezialwissen in (Meta-)Daten gespeichert ist, bleibt es im Unternehmen.
Manuelles Tagging skaliert nicht
Die naheliegende Lösung wäre, jedes Dokument von Hand verschlagworten zu lassen. Für eine kleine, stabile Dokumentenbibliothek kann das funktionieren. Für eine industrielle Wissensbasis mit Hunderttausenden Dateien, Produktvarianten, Revisionen und länderspezifischen Versionen ist das schnell unrealistisch.
Die Arbeit ist langsam, teuer und hört nie wirklich auf. Während ein Team noch das Bestandsarchiv bereinigt, gibt die Konstruktion neue Revisionen frei, der Service veröffentlicht neue Serviceinformationen und die nächste Produktvariante geht ins Feld. Und selbst wenn das Tagging abgeschlossen ist, beginnt es fast sofort zu veralten.
So lösen wir das bei KNOWRON
KNOWRON setzt KI genau dort ein, wo manuelle Arbeit nicht skaliert: große Mengen an Dokumentation lesen, Zusammenhänge zwischen Dateien erkennen und Metadaten vorschlagen. Das System schlägt vor, zu welcher Maschine ein Dokument gehört, welche Version oder welchen Seriennummernbereich es abdeckt und wie es klassifiziert werden sollte. Es kann auch vorschlagen, ob ein Dokument öffentlich, intern oder nur für freigegebene Partner zugänglich sein sollte.
Der entscheidende Punkt dabei: Wir verfolgen einen konsequenten Human-in-the-Loop-Ansatz. Das ist besonders bei Zugriffsrechten wichtig. Die KI bereitet die Entscheidung vor und stellt die relevanten Informationen bereit, aber die Verantwortung dafür, was wem angezeigt wird, bleibt beim Unternehmen.
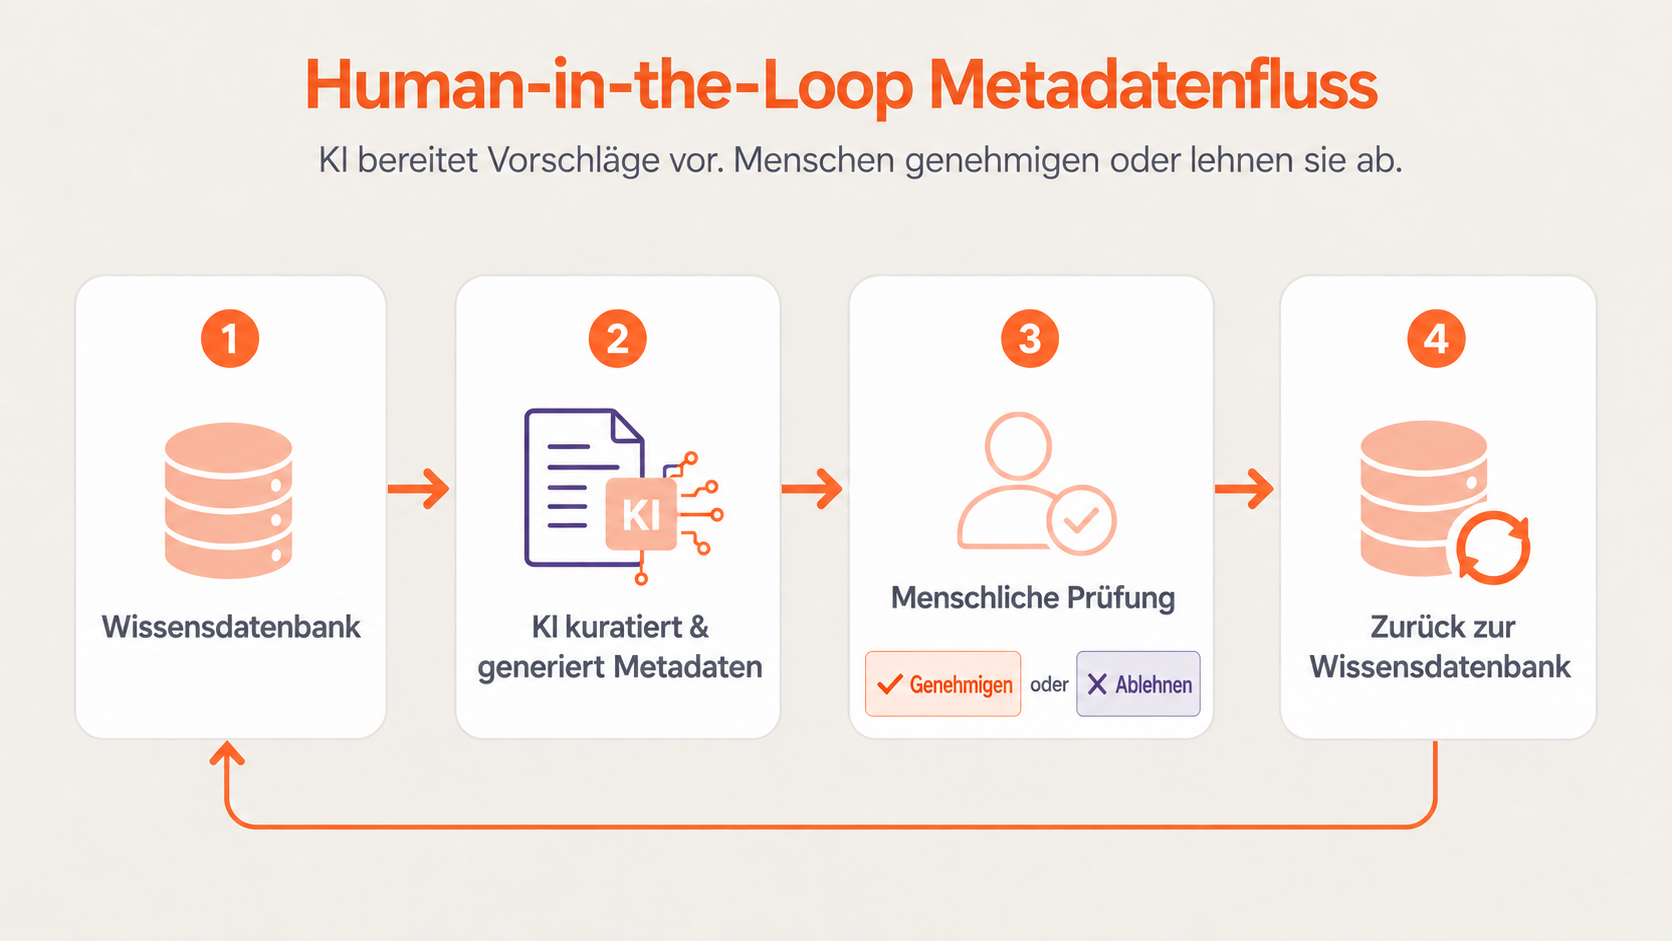
Das macht den Prozess außerdem nachvollziehbar und auditierbar. Es wird dokumentiert, was vorgeschlagen wurde, was freigegeben wurde, wer es freigegeben hat und wann die Änderung wirksam wurde. So wird Governance zum festen Bestandteil des gesamten Prozesses.
KNOWRON verbessert Ihre Daten kontinuierlich
Ein Metadatenprojekt ist keine einmalige Aufräumaktion. Neue Dokumente kommen hinzu, Spezifikationen ändern sich, die Konstruktion gibt die nächste Revision frei. Wenn sich die Metadaten nicht gemeinsam mit der Dokumentation weiterentwickeln, veraltet das System schleichend.
Deshalb prüft KNOWRON Änderungen in der Wissensbasis fortlaufend und schlägt Aktualisierungen vor. Dabei gilt derselbe Freigabeprozess: Das System erkennt, was sich möglicherweise ändern muss, und ein Mensch entscheidet, ob die Änderung korrekt ist.
Das Ergebnis ist eine Wissensbasis, die auch nach dem initialen Rollout nützlich bleibt und nicht zu einem weiteren System wird, das alle sechs Monate lang getestet und dann stillschweigend nicht mehr genutzt haben.
Was Industrielle KI für einen erfolgreichen Rollout braucht
Nach mehr als fünf Jahren in der Praxis kann ich mit Sicherheit sagen: Die Datengrundlage ist einer der zentralen Erfolgsfaktoren für KI-Rollouts in Unternehmen. Wenn der Techniker den QR-Code scannt und sofort das richtige Dokument erhält, wirkt das an der Oberfläche einfach. Darunter muss jedoch ein System stehen, das sich ständig weiterentwickelt: Dokumente, die den richtigen Maschinen zugeordnet sind, aktuelle Revisionsstände, korrekt angewendete Zugriffsregeln und dokumentierte menschliche Entscheidungen dort, wo es darauf ankommt.
KI-Modelle können dabei helfen, Informationen in großem Umfang zu lesen, zu klassifizieren und zu verknüpfen. Nützliche Ergebnisse liefern sie aber nur, wenn das zugrunde liegende Wissen strukturiert, gesteuert und kontinuierlich gepflegt wird. Ohne diese Grundlage liefert selbst die beeindruckendste Oberfläche früher oder später unvollständige, veraltete oder unangemessene Informationen.
In industriellen Umgebungen sind Metadaten keine administrative Nebensache. Sie sind die Infrastruktur, die es KI ermöglicht, die richtige Information zur richtigen Zeit an die richtige Person für die richtige Maschine zu liefern.
Gerne werfen wir einen Blick auf Ihre Datengrundlage und skizzieren Ihnen, wie wir gemeinsam mit Ihnen auf einen erfolgreichen KNOWRON-Rollout hinarbeiten würden. Der Blick in die Daten ist immer der erste Schritt, so wie wir es in den letzten Jahren mit zahlreichen mittelständischen Unternehmen und DAX-Konzernen gemacht haben. Ich bin überzeugt, dass die Art, wie KNOWRON seine Kunden bei ihren Daten unterstützt, einer der wichtigsten Gründe für unsere erfolgreichen Rollouts ist. Ich freue mich auf den Austausch. Schreiben Sie uns an ask@knowron.com.